¿Buscas nuestro logo?
Aquí te dejamos una copia, pero si necesitas más opciones o quieres conocer más, visita nuestra área de marca.
 Conoce nuestra marca.
¿Buscas nuestro logo?
Aquí te dejamos una copia, pero si necesitas más opciones o quieres conocer más, visita nuestra área de marca.
Conoce nuestra marca.
dev
Jorge C. Barrios Hace 18 minutos Cargando comentarios…
En 2023 hablábamos de RAG. En 2026 hablamos de agentes. Pero en cualquier agente serio sigue vivo el mismo problema de siempre cuando trabaja con información: qué recuperar, cuándo y a qué precio.
En este artículo se revisa la literatura científica para contrastar dos hipótesis que argumentan la obsolescencia del RAG: la redundancia de la recuperación ante ventanas de contexto extendidas (1M+ tokens) y el desplazamiento de esta técnica por sistemas basados en agentes. Los datos dicen lo contrario en ambos casos y, además, explican por qué ignorarlos te sale caro.
Si tu sistema todavía recupera información como en 2023, esto te interesa. La pregunta ya no es si el RAG ha muerto. Es cuánto presupuesto de contexto estás desperdiciando sin saberlo.
Seguramente hayas visto el mismo titular en LinkedIn, “X” o en algunas newsletter técnicas: "El RAG ha muerto". Se dice con la misma contundencia que en 2022, cuando nos prometían que el prompt engineering sería la profesión del futuro, o en 2025, cuando aseguraban que los agentes autónomos nos dejarían sin trabajo. Como toda profecía tecnológica, tiene algo de razón, pero también una buena dosis de postureo.
Hagamos lo que mejor sabemos hacer: desmontar los mitos con datos, no con opiniones.
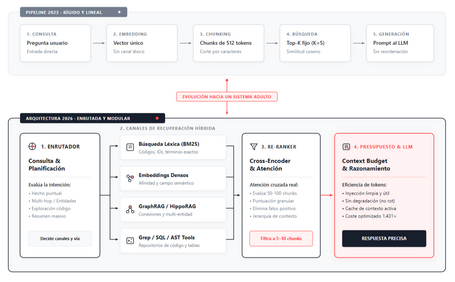
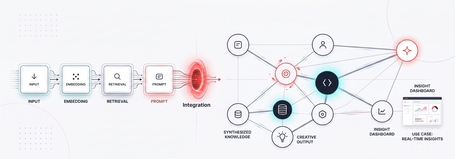
En 2023, el RAG (Retrieval-Augmented Generation) era una arquitectura simple: una pregunta, un embedding, búsqueda de fragmentos (con suerte, un re-ranker), un prompt y listo. Era una serie de cajas con flechas, una detrás de otra, que entusiasmaba a las empresas solo con verlo en una pantalla. En 2026 esa arquitectura es historia. Los modelos manejan ventanas de contexto de un millón de tokens o más, los agentes hacen grep en repositorios, lanzan SQL, llaman a APIs, reformulan una búsqueda si la primera no sirve y arrastran memoria de trabajo entre pasos. El diagrama de cuatro cajas ya no describe casi ningún sistema real.
De ahí la polémica del titular. Pero mi postura es distinta: el RAG no ha muerto. Ha dejado de ser una solución cerrada para convertirse en una pieza básica de ingeniería. Que sea una herramienta más del sistema, y no el sistema completo, es la prueba de que la tecnología ha madurado.
Antes de defender al RAG, quiero ser honesto con quienes lo dan por enterrado, ya que tienen parte de razón. Existen piezas del RAG de 2023 que no tienen sentido en un sistema serio actual. Pienso, por ejemplo, en el top-k fijo sin justificación, en los chunks de 512 tokens por que sí, en usar un único embedding como buscador universal o en depender de una recuperación densa sin componente léxico. Ese pipeline lineal de cinco cajas en fila es, efectivamente, lo que ha muerto.
Tal como ilustra la Figura 1, hemos pasado de este diseño rígido a una arquitectura mucho más modular y enrutada.
Existe una razón técnica contundente para este cambio. Más que un fallo de potencia, nos hemos dado cuenta de límites que antes ignorábamos. Al generar embeddings, nos enfrentamos a un equilibrio casi imposible: capturar el significado general de un texto y, a la vez, distinguir matices muy finos. Es el llamado “dilema de la granularidad”. Los codificadores de texto fallan sistemáticamente cuando dos pasajes comparten el mismo campo semántico, pero difieren en una entidad o hecho concreto.
Lo interesante es que el tamaño del modelo no soluciona esto por sí solo. Un estudio reciente demuestra que un modelo de apenas 0,1B de parámetros, afinado específicamente para esta tarea, supera a modelos de 7B (Xu et al., 2025). El fallo no es de potencia, es de diseño. Por eso, un solo canal de búsqueda vectorial nunca fue, ni es hoy, una base sólida.
Con el chunking ocurre exactamente lo mismo. Trocear en bloques grandes mezcla entidades distintas en un mismo vector y diluye el matiz; trocear en fragmentos diminutos gana precisión sobre la entidad, pero pierde el contexto que le da sentido. Por eso, las soluciones que funcionan en producción no buscan una "talla óptima" de chunk, sino esquemas como el chunking jerárquico: indexar el fragmento pequeño, pero recuperar el párrafo o documento que lo envuelve.
También ha mejorado de verdad el contexto largo y esto no se lo voy a discutir a nadie. Hay modelos que hoy admiten ventanas de uno, dos o incluso diez millones de tokens y esto, obviamente, cambia un poco las reglas del juego de lo que merece la pena recuperar como unidad. Antes se tenía que trocear un documento porque no cabía entero. Ahora, en muchos casos, puedes meter el documento completo. Eso no es marketing, es una mejora arquitectónica real. Pero esto no justifica que puedas meter todo el corpus en un prompt, y aquí es donde el relato del “contexto infinito” empieza a chocar con los números y la realidad.
Este es el argumento que más titulares acapara: si los modelos ya manejan ventanas de uno o dos millones de tokens, ¿para qué molestarse en recuperar nada? Basta con inyectar todo. El problema técnico es que un modelo no presta atención de forma uniforme a toda esa ventana. Este fenómeno es conocido como Context Rot (o degradación del contexto): cuanta más información inyectamos, más ruido introducimos, y peor razona el modelo (Liu et al., 2024).
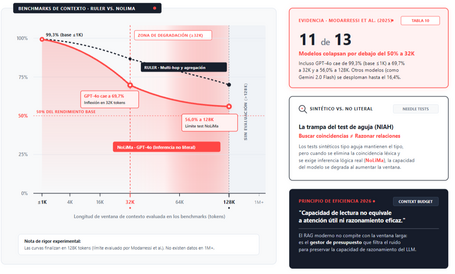
El benchmark RULER destapó este espejismo en 2024. En aquel momento, aunque la mayoría de los modelos afirmaban soportar ventanas de 32K tokens o más, solo el 50% mantenía un rendimiento aceptable en condiciones de uso real (Hsieh et al., 2024).
El resultado que, a mi juicio, más cambia la perspectiva sobre este problema es NoLiMa. Mientras que RULER suele permitir que el modelo encuentre la respuesta por mera coincidencia léxica, NoLiMa elimina esa "pista" y obliga al modelo a razonar semánticamente. Los resultados fueron reveladores: de 13 modelos que prometían contextos de al menos 128K tokens, 11 caían por debajo del 50 % de su rendimiento al llegar a 32K. Incluso un referente como GPT-4o pasaba de un 99,3 % de acierto en contexto corto a un 69,7 % en condiciones de contexto largo (Modarressi et al., 2025)*.
La Figura 2 sintetiza visualmente este fenómeno: mientras que la coincidencia léxica permanece estable, la capacidad de razonamiento real colapsa drásticamente al superar los 32K tokens.
*Dada la vertiginosa velocidad en el desarrollo de nuevos modelos, es fundamental verificar las versiones y arquitecturas específicas referenciadas en Modarressi et al., 2025, antes de generalizar sus resultados.
Además, debemos considerar que casi toda esta evidencia se mide en inglés. Cuando esta capacidad se prueba en 26 idiomas a la vez, la brecha de rendimiento entre lenguas con muchos y pocos recursos se triplica a medida que crece la ventana (Kim et al., 2025; Hengle et al., 2026; Wang et al., 2026; Qi et al., 2025).
Toda esta evidencia apunta en la misma dirección:
Que un modelo pueda pagar el coste de leer un millón de tokens no significa que ese millón de tokens sea atención útil.
Por eso prefiero ver la recuperación no como una técnica que compite con el contexto largo, sino como el gestor de nuestro presupuesto. Cada llamada al modelo es un recurso finito que debemos repartir entre instrucciones, historial, memoria y los documentos recuperados. La recuperación es la función que decide qué parte del mundo merece ocupar ese espacio. Cuanto más grande es la ventana, más caro sale desperdiciarla. Recuperar información con precisión es hoy más crítico que nunca.
Este es, a mi juicio, el argumento más sólido de quienes dan por muerto al RAG. Sin embargo, analicémoslo con lupa. La mayoría de los agentes deciden su siguiente paso según lo que acaban de observar, no según un guión fijo, y en algún punto de ese bucle, casi siempre aparece la misma pregunta: ¿qué necesito saber antes de seguir? Esa pregunta es recuperación, aunque ya no lleve esa etiqueta.
Un agente no sigue un flujo lineal. Debe planificar, buscar, evaluar resultados, decidir si necesita más información, consultar herramientas y comparar antes de escribir una sola palabra. Incluso cuando la estrategia de búsqueda se vuelve multinivel, la esencia operativa sigue siendo la recuperación de datos. Lo que ha evolucionado no es la acción de recuperar en sí, sino la inteligencia orquestadora del sistema para discernir qué canales consultar y en qué momento preciso ejecutar cada estrategia.
La evidencia actual demuestra que permitir que un agente realice búsquedas exhaustivas no solo es costoso, sino que a menudo, es contraproducente. Un benchmark reciente, ContextBench, analizó el comportamiento de distintos modelos (GPT-5, Claude Sonnet 4.5 y Devstral 2) operando como agentes autónomos sobre cientos de incidencias reales. Los resultados desmontan la intuición de que "más búsqueda equivale a mejor respuesta".
El análisis es claro: la exploración agresiva en donde el agente realiza rondas de búsqueda excesivas, dispara el consumo de tokens y el coste operativo y, además, no garantiza una mayor calidad (Li et al., 2026). Por el contrario, los modelos que adoptan un enfoque moderado alcanzan un equilibrio superior y logran un mejor desempeño sin necesidad de saturar el sistema con consultas redundantes. La lección de todo esto es que la exploración agresiva por parte de los agentes solo infla el gasto, no la precisión. Leer más no equivale a recuperar mejor.
En la práctica, lo que estamos viendo consolidarse en 2026 son pipelines híbridos (Hybrid Pipelines) que optimizan los recursos. Un patrón exitoso suele ser:
Este enfoque es más caro que un simple embedding, sí, pero infinitamente más eficiente que saturar al LLM con cien fragmentos aleatorios. Como confirma el estudio de Assadi et al. (2026), en búsquedas semánticas, un buen modelo de embeddings supera a cualquier combinación que intente usar un LLM para reordenar resultados desde cero. Gastar el modelo caro donde no hace falta no solo aumenta el coste; a menudo, ni siquiera mejora el resultado.
Otro patrón exitoso, basado en una arquitectura que se asienta sobre un bucle de razonamiento reflexivo (Reasoning Loop), suele ser:
Evidentemente, esta sofisticación orquestadora plantea un desafío pragmático de primer orden: la latencia acumulada y el coste por consulta. Sin embargo, delegar cada micro-decisión de este bucle a un LLM de frontera es económicamente insostenible. Las arquitecturas que escalan aplican un enfoque en capas: utilizan modelos de embeddings y re-rankers (cross-encoders) para filtrar el contexto de forma eficiente, reservando el LLM pesado únicamente para la fase de síntesis final. Este filtrado especializado reduce drásticamente el ruido y el coste operativo, garantizando que solo la evidencia de mayor calidad llegue al modelo de razonamiento.
Por otro lado, cuando la consulta requiere unir conceptos relacionados a través de varios documentos, los vectores fallan. Aquí es donde los grafos de conocimiento resuelven la ecuación, permitiendo al modelo razonar sobre conexiones explícitas.
Estos han demostrado ser superiores a la búsqueda vectorial pura (Pan et al., 2024; Chen et al., 2024). Antiguamente, el problema era el coste de construir el grafo entero. Pero implementaciones recientes como GraphRAG (Edge et al., 2024) y soluciones optimizadas como LazyGraphRAG (Edge et al., 2024), HippoRAG (Gutiérrez et al., 2024) o LightRAG (Guo et al., 2025) permiten extraer relaciones semánticas complejas con costes de indexación reducidos, siendo GraphRAG-bench (Xiao et al., 2025) una referencia clave para evaluar la capacidad de razonamiento en estos entornos.
En definitiva, este ecosistema de técnicas (desde la recuperación híbrida hasta la orquestación mediante agentes y grafos de conocimiento) no ofrece soluciones universales. El éxito radica en la composición modular de estos mecanismos según la complejidad y la intención de cada consulta.
Por tanto, el debate útil en 2026 ya no es "¿RAG o agentes?". La pregunta correcta es: ¿qué mecanismo de recuperación debe usar cada agente, en qué momento del razonamiento y con qué presupuesto? El agente no sustituye al RAG, lo absorbe como una capacidad interna.
En entornos corporativos, el cuello de botella no suele ser la tecnología, sino el presupuesto. Obligar a los modelos a procesar contextos inmensos por defecto arruina la viabilidad económica de cualquier producto. La precisión al filtrar información no es solo un reto técnico, es disciplina financiera para que la factura de la nube no se coma el margen de negocio.
Tal como ilustra la Figura 3, este impacto económico se hace evidente al desglosar el pipeline en tres etapas: desde la recuperación inicial de bajo coste hasta el razonamiento final con modelos de frontera.
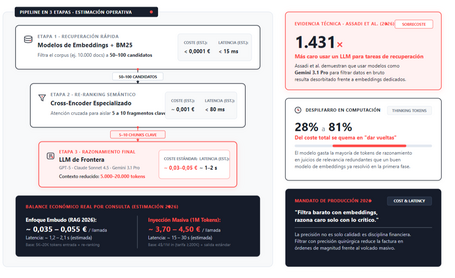
Un millón de tokens cuesta dinero y tiempo. Mientras una búsqueda híbrida eficiente filtra datos en milisegundos. Obligar al modelo a procesar todo el repositorio antes de escribir la primera palabra dispara la latencia a varios segundos. Para un asistente conversacional, enviar cientos de miles de tokens por llamada no solo es caro, es una pésima experiencia de usuario. El objetivo en producción nunca es saturar al modelo con datos superfluos, sino entregarle con mucha precisión los pocos tokens determinantes para la decisión.-
Los propios proveedores lo confirman al lanzar funciones como el _context caching (la caché de contexto en Gemini o Claude). Estas herramientas son un complemento a la recuperación inteligente, nunca un sustituto, diseñadas precisamente para no pagar ni esperar por los mismos datos una y otra vez.
Los datos respaldan esta cautela. Assadi et al. (2026) demuestran que, aunque los LLMs alcanzan resultados competitivos, el coste es desproporcionado. Usar un modelo como Gemini 3.1 Pro para tareas de recuperación puede ser hasta 1.431 veces más caro que emplear un modelo de embeddings especializado. Además, la velocidad de procesamiento de los LLMs es drásticamente menor. En términos de eficiencia, los tokens dedicados al "razonamiento" suponen entre el 28 % y el 81 % del coste total. Muchas veces, el modelo da vueltas sobre juicios de relevancia que ya tenía claros en la primera lectura, inflando la factura sin mejorar el resultado.
La lección es clara:
Usa modelos de embeddings para el grueso del trabajo y reserva el LLM para el razonamiento final que de verdad lo necesita.
La pregunta para quién diseña un sistema de IA generativa ya no debería ser "¿cuántos tokens soporta mi modelo?", sino "¿cuál es el presupuesto de contexto óptimo para cada paso de mi sistema?"
Es hora de dejar de lado los debates teóricos y ser pragmáticos. Si tu sistema actual sigue anclado en las premisas de 2023, como la fragmentación estática, la búsqueda vectorial ciega y un flujo lineal rígido, es natural que los resultados no estén a la altura.
El problema no es que el RAG haya muerto. El problema es que estás intentando resolver retos actuales con una arquitectura obsoleta. Tu pipeline necesita dejar de ser un simple buscador para convertirse en un sistema de decisiones.
Para modernizarlo, cualquier solución en producción debe resolver estas seis preguntas críticas:
El término "RAG" ha perdido protagonismo frente al discurso de los agentes, pero la recuperación de información no ha desaparecido. Simplemente, ha dejado de ser un componente aislado. Ya no necesita un nombre propio porque es, sencillamente, una capacidad inherente.
Como ilustra la Figura 4, la recuperación es el tejido conectivo del agente. Ya sea consultando una base de datos, un documento, código o una política interna, el flujo es constante: el agente determina la necesidad, el sistema valida el acceso, el recuperador filtra el contenido y el modelo razona sobre la información seleccionada.
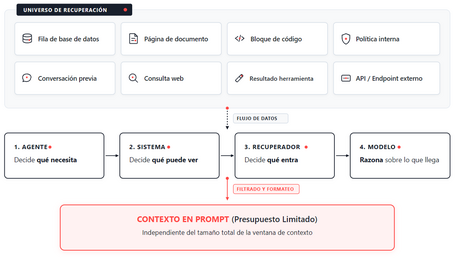
Por eso, "¿ha muerto el RAG?" me parece la pregunta equivocada para 2026. La incógnita real que debemos resolver en cada proyecto es más técnica y menos estética: ¿cuánto presupuesto de contexto estamos desperdiciando?
El RAG ya no debe entenderse como una arquitectura rígida dibujada en una diapositiva, es una función básica de cualquier sistema de IA generativa. Cuanto más grandes son las ventanas de contexto, más vital resulta ejecutar esta función con precisión.
Entonces:
Lo que ha muerto no es el RAG. Ha muerto tu pipeline de 2023.
Si te ha resultado útil este repaso, compártelo con quien todavía esté discutiendo si "el RAG ha muerto" en lugar de discutir cómo debería recuperar su sistema.
Assadi, A. E., Muennighoff, N., & Lee, J. (2026). The Embedder's Dilemma: LLMs Are Better, but at What Cost?. arXiv preprint arXiv:2608.12875.
Chen, Z., Zhang, Y., Fang, Y., Geng, Y., Guo, L., Chen, X., ... & Chen, H. (2024). Knowledge graphs meet multi-modal learning: A comprehensive survey. arXiv preprint arXiv:2402.05391.
Edge, D., Trinh, H., Cheng, N., Bradley, J., Chao, A., Mody, A., ... & Larson, J. (2024). From local to global: A graph rag approach to query-focused summarization. arXiv preprint arXiv:2404.16130.
Edge, J. L. D., Trinh, H., & Larson, J. (2024). Lazygraphrag: Setting a new standard for quality and cost. Microsoft Blog.
Guo, Z., Xia, L., Yu, Y., Ao, T., & Huang, C. (2025, November). LightRAG: Simple and Fast Retrieval-Augmented Generation. In EMNLP (Findings) (pp. 10746-10761).
Gutiérrez, B. J., Shu, Y., Gu, Y., Yasunaga, M., & Su, Y. (2024). Hipporag: Neurobiologically inspired long-term memory for large language models. Advances in neural information processing systems, 37, 59532-59569.
Hengle, A., Bajpai, P., Dan, S., & Chakraborty, T. (2026, March). Can LLMs reason over extended multilingual contexts? Towards long-context evaluation beyond retrieval over haystacks. In Proceedings of the 19th Conference of the European Chapter of the Association for Computational Linguistics (Volume 1: Long Papers) (pp. 6128-6152).
Hsieh, C. P., Sun, S., Kriman, S., Acharya, S., Rekesh, D., Jia, F., ... & Ginsburg, B. (2024). RULER: What's the real context size of your long-context language models?. arXiv preprint arXiv:2404.06654.
Kim, Y., Russell, J., Karpinska, M., & Iyyer, M. (2025). One ruler to measure them all: Benchmarking multilingual long-context language models. arXiv preprint arXiv:2503.01996.
Li, H., Zhu, L., Zhang, B., Feng, R., Wang, J., Pan, Y., ... & Ye, H. (2026). Contextbench: A benchmark for context retrieval in coding agents. arXiv preprint arXiv:2602.05892.
Liu, N. F., Lin, K., Hewitt, J., Paranjape, A., Bevilacqua, M., Petroni, F., & Liang, P. (2024). Lost in the middle: How language models use long contexts. Transactions of the association for computational linguistics, 12, 157-173.
Modarressi, A., Deilamsalehy, H., Dernoncourt, F., Bui, T., Rossi, R. A., Yoon, S., & Schütze, H. (2025). Nolima: Long-context evaluation beyond literal matching. arXiv preprint arXiv:2502.05167.
Pan, S., Luo, L., Wang, Y., Chen, C., Wang, J., & Wu, X. (2024). Unifying large language models and knowledge graphs: A roadmap. IEEE Transactions on Knowledge and Data Engineering, 36(7), 3580-3599.
Qi, J., Fernández, R., & Bisazza, A. (2025, November). On the consistency of multilingual context utilization in retrieval-augmented generation. In Proceedings of the 5th Workshop on Multilingual Representation Learning (MRL 2025) (pp. 199-225)
Su, H., Yen, H., Xia, M., Shi, W., Muennighoff, N., Wang, H. Y., ... & Yu, T. (2025, May). Bright: A realistic and challenging benchmark for reasoning-intensive retrieval. In International Conference on Learning Representations (Vol. 2025, pp. 48941-48991).
Wang, D., Mo, G., Shi, Y., Zhang, C., Zheng, B., Cao, B., ... & Sun, L. (2026, July). All Languages Matter: Understanding and Mitigating Language Bias in Multilingual RAG. In Proceedings of the 64th Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers) (pp. 7441-7455).
Xiao, Y., Dong, J., Zhou, C., Dong, S., Zhang, Q. W., Yin, D., ... & Huang, X. (2025). Graphrag-bench: Challenging domain-specific reasoning for evaluating graph retrieval-augmented generation. arXiv preprint arXiv:2506.02404.
Xu, L., Su, Z., Yu, M., Li, J., Meng, F., & Zhou, J. (2025). Dense retrievers can fail on simple queries: Revealing the granularity dilemma of embeddings. Passages, 3024, 8.

Jorge C. Barrios
Mi día a día gira en torno a la Inteligencia Artificial desde hace diez años, un campo que abordo siempre desde la fascinación por su ciencia y fundamentos. Curioso por naturaleza y apasionado del aprendizaje continuo. Me sigo perdiendo entre los libros y la teoría para traducir conceptos, datos e investigación en tecnología útil.
Ver más contenido de Jorge C..Leer más.


Los comentarios serán moderados. Serán visibles si aportan un argumento constructivo. Si no estás de acuerdo con algún punto, por favor, muestra tus opiniones de manera educada.

Cuéntanos qué te parece.