¿Buscas nuestro logo?
Aquí te dejamos una copia, pero si necesitas más opciones o quieres conocer más, visita nuestra área de marca.
 Conoce nuestra marca.
¿Buscas nuestro logo?
Aquí te dejamos una copia, pero si necesitas más opciones o quieres conocer más, visita nuestra área de marca.
Conoce nuestra marca.
dev
Jorge C. Barrios Hace 16 minutos Cargando comentarios…
La eficacia de un sistema RAG depende intrínsecamente de cómo fragmentamos nuestro corpus, pero la práctica común de copiar estrategias de configuración por defecto sin medir es un error fundamental.
No existe una estrategia de chunking universalmente ganadora. El rendimiento varía significativamente según el dominio, la estructura del texto y el modelo de embeddings que usemos. Por tanto, optimizar esta etapa no es una tarea trivial de configuración inicial, sino un proceso activo de auditoría.
El mayor riesgo reside en el "truncamiento ciego", un fenómeno silencioso donde los fragmentos exceden la ventana del modelo y son recortados durante la vectorización, degradando la búsqueda sin generar errores. Auditar este comportamiento y medir la relevancia de las respuestas con consultas reales es indispensable.
Este proceso es una inversión necesaria de tiempo y análisis que permite asegurar que el sistema no esté limitando su potencial desde la propia fase de indexación.
Seguramente hayas visto esta línea de código o una que se le parece mucho. Está en el repositorio de casi todos los RAG que llevan un tiempo en producción:
splitter = RecursiveCharacterTextSplitter(chunk_size=1000, chunk_overlap=200)
Esa línea determina cómo se fragmenta cada documento antes de su indexación y establece el tamaño de los segmentos. Es una configuración crucial: un sistema RAG no recupera documentos completos, sino fragmentos y, por lo tanto, la calidad de las respuestas depende directamente de cómo realice ese recorte.
Estos mil caracteres y los doscientos de solape de ejemplo suelen ser herencia del tutorial que consultaste al iniciar el proyecto (¡y lo sabes!). Aunque te pueda sorprender, no voy a criticar el uso de esa configuración por defecto.
Un troceado recursivo bien parametrizado es difícil de superar, algo que respaldan incluso fuentes que podrían beneficiarse de afirmar lo contrario, como demostraré a continuación con datos objetivos.
El enemigo del chunking es otro, y es bastante más incómodo: haber elegido esa configuración una vez y no haberla medido nunca.
Una de las decisiones con mayor impacto en la calidad de respuesta del sistema se toma habitualmente por defecto, replicando configuraciones externas sin evaluación previa. Su manifestación más frecuente es reaccionar sintomáticamente ante fallos en la recuperación sustituyendo el splitter por un algoritmo más complejo, omitiendo una validación cuantitativa previa de su impacto real.
Mi postura es que el chunking no es una decisión de arquitectura que se toma el primer día, es un parámetro que se mide sobre los documentos propios.
Por eso este artículo no va a dar un chunk_size recomendado, va a dar la forma de medir el tuyo. El fallo no es ni de estrategia ni de método, el fallo es de medición.
¡Ah! y si piensas que el RAG ha muerto, pásate por otra publicación en donde discutimos sobre ello.
El troceado recursivo con una ventana y solapamiento fijo nos puede parecer una estrategia muy básica, de principiantes, pero es un método que funciona. En 2024 Chroma publicó una evaluación de estrategias de chunking sobre cinco colecciones de texto (Smith y Troynikov, 2024). Curiosamente, el resultado que más se cita de ese informe es justo el que peor le venía a ellos.
El método de chunking recursivo a 200 tokens obtuvo un 88,1 % de recall. Sorprendentemente, el chunker semántico de la propia Chroma se queda en 87,3%.
Destaquemos un aspecto: quien hizo este estudio es una empresa que vende bases de datos vectoriales y cuyos resultados nos dicen que la heurística de toda la vida recupera algo más que el chunker sofisticado que ella misma propone.
La conclusión que escriben los autores es la concesión entera: las heurísticas simples funcionan bien en la práctica cuando están bien parametrizadas.
Hay un segundo aspecto menos citado pero determinante que debemos tener en cuenta. Evaluar el chunking con rigor va mucho más allá de cambiar un parámetro y comprobar que la demo sigue respondiendo. Aunque el estándar tradicional exige construir un dataset (ground truth) sobre tu propio corpus, un proceso costoso y difícil de escalar, no es el único camino.
Hoy existen alternativas validadas en la literatura: desde la síntesis automatizada de casos de prueba (Ragas, ARES), hasta el análisis aislado del retriever mediante métricas clásicas de recuperación de información como Hit Rate, MRR o NDCG (benchmark BEIR), pasando por la auditoría de relevancia contextual mediante el paradigma LLM-as-a-judge.
Además, y esto ya es una opinión sin datos por detrás, el chunking se percibe como fontanería previa al trabajo interesante. Se despacha en la primera semana del proyecto para pasar cuanto antes a la ingeniería de prompt, re-ranking o sistema agéntico.
Pongamos de ejemplo un análisis sencillo, un ejercicio de juguete para ilustrar los conceptos. No pretendemos realizar aquí una investigación profunda, sino mostrar los pasos prácticos para evaluar nuestro chunking y cómo algunos factores a menudo ignorados afectan a la calidad de las respuestas.
He aplicado cuatro estrategias de chunking sobre un mismo documento: una política interna sobre “Días libres, vacaciones y ausencias.pdf” de Paradigma Digital. Contiene 9 páginas, 18.638 caracteres con títulos, preguntas frecuentes y listas numeradas. El documento tipo de cualquier empresa.
El documento es interno, solo voy a publicar las cifras y los cortes, no el texto. El modelo empleado para la prueba es paraphrase-multilingual-MiniLM-L12-v2 (con una longitud máxima de secuencia de 128 tokens).
Al evaluar cómo fragmentar un documento, nos encontramos con cuatro enfoques principales, cada uno con un equilibrio distinto entre costo, predictibilidad y coherencia contextual. Como ilustra la figura 1, estas estrategias generan rangos de tamaño muy dispares sobre el mismo documento, lo que condiciona directamente la efectividad de la recuperación:
No existe una estrategia ganadora absoluta. Cada método gana en algo y rompe en otra cosa dependiendo de la naturaleza del texto. La elección no debe ser un sorteo basado en la popularidad del método, sino una decisión fundamentada en cómo cada estrategia gestiona las unidades de información de tu corpus.
Lo primero que podemos observar y analizar es la longitud de los fragmentos para cada una de las estrategias. Esto nos sirve para hacernos una idea de la disparidad en los tamaños resultantes, lo cual es el primer indicador de cómo cada estrategia afecta la granularidad de la información.
En la figura 1 se muestra el rango de resultados aplicados al documento de referencia.
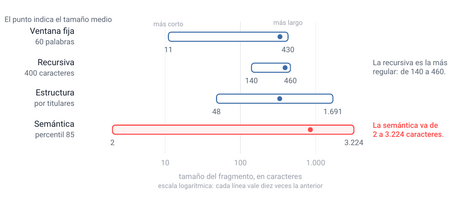
En la figura 1 tenemos más datos del proceso. Por cada estrategia obtenemos un número de chunks específico: 72, 56, 50 y 22 fragmentos, y ninguna de las cuatro merece la pena desecharla de buenas a primeras. Menos fragmentos no es un indicador mejor.
Esto nos lleva al dilema fundamental de la granularidad: un compromiso constante entre el contexto general y los detalles finos. Fragmentos demasiado pequeños ganan en precisión para consultas directas, pero corren el riesgo de perder el hilo conductor necesario para entender la respuesta completa.
Por el contrario, fragmentos excesivamente extensos preservan el contexto, pero a menudo "diluyen" la información relevante, dificultando que el sistema localice el dato concreto. Encontrar el punto de equilibrio no es una ciencia exacta, sino un ajuste fino que depende totalmente de cómo está estructurada la información en tu corpus.
En la siguiente tabla también se puede observar cuántos tokens ocupa cada uno de esos fragmentos en comparación con los 128 tokens de longitud de ventana que establece el modelo utilizado. Este límite marca el umbral del fenómeno de truncamiento ciego, que introduce un sesgo semántico peligroso al comprometer la representación vectorial del fragmento.
Es un problema de "ceguera parcial": el LLM recibe la información completa, pero el sistema de recuperación, que actúa como filtro de entrada, nunca llegó a procesar esa información durante la fase de búsqueda. Esto explica, a veces, por qué el sistema puede recuperar un fragmento aparentemente relevante basándose únicamente en su inicio, pero ofrecer una respuesta pobre porque el núcleo de la información estaba en los tokens descartados.
| Estrategia | N.º de chunks | Caracteres medios | Máximo | Tokens (máx.) |
|---|---|---|---|---|
| Fija (60 palabras) | 72 | 336 | 430 | 100 |
| Recursiva (400 car.) | 56 | 391 | 460 | 122 |
| Estructura | 50 | 333 | 1.691 | 384 |
| Semántica | 22 | 845 | 3.224 | 761 |
Tabla 1. Comparativa de las cuatro estrategias de chunking aplicadas sobre el documento “Días libres, vacaciones y ausencias.pdf”.
Y aquí está el motivo por el que este fallo sobrevive años dentro de un sistema en producción: lo que excede la ventana se descarta al vectorizar sin error y sin aviso.
Es un proceso totalmente silencioso, no se generan excepciones, advertencias ni errores en los logs del sistema. El fragmento entra en el índice, ocupa su vector y se comporta con toda normalidad. Solo que ese vector representa sus primeros 128 tokens y nada más.
El texto completo sí llega al LLM, porque viaja en el payload. Pero no participó en la búsqueda. Lo que decidió si ese fragmento se recuperaba o no fue un fragmento del fragmento, es decir, una pérdida de información descomunal.
La Figura 2 ilustra este fenómeno. El umbral de 128 tokens no diferencia entre estrategias eficaces e ineficaces. En su lugar, atraviesa la distribución de aquellas que, por su naturaleza, se ajustan mejor a la estructura del documento.
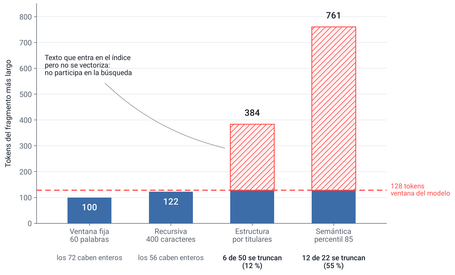
Por tanto, antes de analizar métricas de recuperación o ajustar el tamaño de ventana, la auditoría del truncamiento es un paso obligatorio. Si tus fragmentos están siendo cortados ciegamente por el modelo de embeddings, cualquier optimización posterior será en vano porque el sistema estará indexando información incompleta.
Evaluar este fenómeno es, en última instancia, la primera prueba de estrés para verificar si tu estrategia de chunking es realmente funcional o si está limitando el potencial de tu RAG desde el primer día. Ese es el primer dato que conviene tener sobre la mesa antes de discutir qué estrategia es mejor.
En este caso solo las estrategias fija y recursiva permiten fijar el tamaño del fragmento. Esta calibración solo tiene sentido con estas estrategias que suelen ser las más habituales cuando se comienza por a crear un sistema RAG.
Se ha indexado el mismo documento con tres configuraciones de tamaño y solape, medidas en palabras, y se ha lanzado una consulta de las que hace cualquier empleado: ¿cuántos días de vacaciones pendientes se pueden arrastrar y hasta cuándo?
El score que podemos observar en la tabla 2 es la similitud coseno entre el vector de la pregunta y el vector del fragmento top-1, calculada sobre un índice construido desde cero para cada configuración. No mide si la respuesta está completa, solo la cercanía geométrica entre los dos.
| Tamaño / solape (palabras) | Fragmentos generados | Score del top-1 | ¿Contiene la respuesta? |
|---|---|---|---|
| 30 / 5 | 124 | 0,6868 | No: devuelve permisos de 8 semanas |
| 60 / 15 | 72 | 0,7704 | Sí, cortada en "antes del 31 de marzo del año" |
| 120 / 30 | 39 | 0,7690 | Sí y completa: "del año en curso" |
Tabla 2. Resultado de la consulta piloto sobre tres configuraciones de tamaño y solape, mismo documento.
Los resultados muestran tres cosas a la vez:
Lo que enseña este ejemplo podríamos resumirlo en una frase: un sistema puede devolver un score alto, sobre el documento correcto y en la página correcta, y aun así entregar una respuesta a la que le falta información.
Esta falta de información puede ser “rellenada” por el LLM en su respuesta y es otro foco de alucinaciones a los que debemos prestar atención.
Ahora la letra pequeña, antes de que la escriba nadie en los comentarios. Esto es una consulta, un documento y un top-1. Es decir, ilustra un mecanismo, no lo mide. Con otra pregunta, el orden de los scores puede cambiar y el ganador de esta tabla no es una recomendación de tamaño para nadie. Es la prueba de que hay que medir el corpus y no copiar configuraciones de nadie.
Hasta ahora hemos analizado un caso de “juguete”, un documento, un experimento rápido y una consulta de muestra. Es momento de contrastar estas observaciones con la evidencia a escala y evaluar si las técnicas emergentes realmente superan los problemas de truncamiento que hemos detectado.
En este estudio de Shaukat et al. (2026) se ha medido con 1.080 configuraciones, aplicando 36 estrategias de chunking, seis dominios y cinco modelos de embeddings, con la recuperación aislada del resto del sistema. Los resultados del estudio, después de todo ese volumen, es lo que venimos diciendo en el post, no hay ganador único. Por ejemplo, la estrategia del troceado dinámico domina en Biología, Salud y Física. La agrupación por párrafos gana en Legal y Matemáticas. Y en el dominio de Agricultura ningún método destaca con claridad.
De esta investigación se extrae una conclusión fundamental: no existe una estrategia universal, ya que la eficacia de cada método depende intrínsecamente del dominio, del corpus.
Además, es un error intentar compensar una estrategia de segmentación deficiente mediante el uso de modelos de embeddings más avanzados.
Dado que el chunking y los embeddings operan de forma multiplicativa y no como alternativas excluyentes, una mala segmentación limitará irremediablemente el rendimiento de cualquier modelo, independientemente de su coste o sofisticación.
La pregunta con la que casi todos llegamos a este tema es: ¿cuál es la mejor estrategia de chunking? Es la pregunta equivocada y sigue sin respuesta tal y como hemos visto en este post.
La estrategia ideal no es inmutable: su rendimiento oscila según el dominio, el modelo de embeddings y la estructura de tus documentos.
Por eso, la pregunta clave no es cuál es la mejor, sino qué cuota de precisión estamos perdiendo al no auditar nuestra propia configuración de chunking.
Resolver esta cuestión es un proceso que requiere tiempo y un análisis consciente. Dedicar unos días a auditar cuántos fragmentos exceden la ventana del modelo, preparar consultas representativas junto a expertos de negocio y probar distintas configuraciones, entre otras cosas, es una inversión que merece la pena. No es necesario un benchmark complejo, lo que realmente se requiere es dedicación.
La esencia de este artículo se resume en una única máxima: no adoptes una estrategia de chunking por inercia, mide la tuya.
Y si conoces a alguien que montó su RAG hace año y medio y desde entonces no ha vuelto a abrir el fichero donde vive el splitter, compárteselo. Es quien más tiene que ganar dedicando unos días a esta revisión.

Jorge C. Barrios
Mi día a día gira en torno a la Inteligencia Artificial desde hace diez años, un campo que abordo siempre desde la fascinación por su ciencia y fundamentos. Curioso por naturaleza y apasionado del aprendizaje continuo. Me sigo perdiendo entre los libros y la teoría para traducir conceptos, datos e investigación en tecnología útil.
Ver más contenido de Jorge C..Leer más.
Los comentarios serán moderados. Serán visibles si aportan un argumento constructivo. Si no estás de acuerdo con algún punto, por favor, muestra tus opiniones de manera educada.

Cuéntanos qué te parece.