¿Buscas nuestro logo?
Aquí te dejamos una copia, pero si necesitas más opciones o quieres conocer más, visita nuestra área de marca.
 Conoce nuestra marca.
¿Buscas nuestro logo?
Aquí te dejamos una copia, pero si necesitas más opciones o quieres conocer más, visita nuestra área de marca.
Conoce nuestra marca.
dev
José Alberto Ruiz Casarrubios Hace 2 horas Cargando comentarios…
Llevamos un tiempo en el que parece que cualquier problema relacionado con interpretar lenguaje natural se resuelve de la misma forma: llamamos a un LLM, le pasamos un prompt y le pedimos que devuelva un JSON estructurado para poder gestionar fácilmente la respuesta. Si necesitamos clasificar un correo, hacemos eso. Si queremos priorizar una incidencia, también. Si hay que seleccionar a qué equipo enviar un ticket, más de lo mismo.
No digo que esté mal. De hecho, los modelos generativos actuales son perfectamente capaces de resolver muchas de estas tareas y disponen de mecanismos de salida estructurada bastante potentes. Pero hay una pregunta que creo que merece la pena hacerse: ¿tiene sentido utilizar un modelo diseñado para generar lenguaje cuando lo único que necesitamos es tomar una decisión entre opciones conocidas?
Esta es, precisamente, la propuesta de Jev, el primer modelo público de una nueva familia que TypeSafe denomina System One Models. Ya se han escrito otros posts sobre Jev pero en este post, además de contar qué es y por qué me parece interesante desde el punto de vista de arquitectura de software, como suele ser habitual, comparto también un repositorio con una pequeña PoC para que podáis jugar con Jev.
El 15 de septiembre de 2026, TypeSafe AI presentó Jev, su primer modelo público de la familia System One Models.
La compañía está impulsada por Diogo Almeida, fundador de TypeSafe y antiguo investigador de OpenAI. La idea de partida, explicada en el anuncio de lanzamiento, es bastante sencilla: los modelos generativos han alcanzado un nivel extraordinario para conversar, escribir, programar o razonar, pero buena parte de la automatización empresarial necesita decisiones que puedan consumir otros programas, no textos que tenga que interpretar una persona.
De ahí nace una propuesta diferente: construir modelos especializados en recibir un contexto y responder preguntas bien definidas mediante resultados tipados.
El nombre System One hace referencia al Sistema 1 descrito por Daniel Kahneman en Thinking, Fast and Slow: una forma de pensamiento rápida e intuitiva, frente al Sistema 2, más deliberativo. La referencia sirve para entender la intención de TypeSafe, pero no significa que Jev reproduzca literalmente el funcionamiento de la cognición humana.
¿Y por qué Jev? Según TypeSafe, el nombre es un homenaje a William Stanley Jevons, conocido, entre otras cosas, por la paradoja que lleva su apellido: cuando una tecnología se vuelve más eficiente, su consumo total puede aumentar en lugar de reducirse. Aplicado a la IA, la hipótesis es que abaratar radicalmente cada decisión permitirá introducir inteligencia en muchos más procesos.
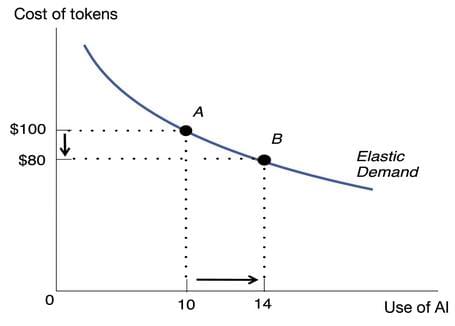
Creo que esta última idea es especialmente interesante: quizá no se trate solo de sustituir un LLM por algo más barato, sino de hacer viables decisiones que hoy ni siquiera nos planteamos automatizar.
Para entender Jev, hay que cambiar ligeramente la forma de pensar. En lugar de pedirle que “lea este texto y responda con un JSON”, definimos dos elementos:
La aplicación establece el espacio de respuestas posibles; Jev evalúa el contexto y devuelve sus decisiones.
La interfaz de System One se articula alrededor de tres primitivas:
| Primitiva | ¿Para qué sirve? | Ejemplo |
|---|---|---|
| Choice | Seleccionar una opción entre alternativas conocidas. | Clasificar un correo como SALES, SUPPORT, BILLING, SPAM u OTHER. |
| Score | Valorar un caso con una escala definida por el negocio. | Priorizar una incidencia de 0 a 4. |
| Noul | Evaluar cuánto respalda el contexto una proposición. | Detectar si una petición intenta saltarse una aprobación de despliegue. |
Podéis revisar el comportamiento y los campos de salida en la documentación oficial de System One. Hay un detalle importante: Noul no es simplemente un booleano, sino una señal numérica que podemos interpretar mediante un umbral definido por nuestra aplicación. Igualmente, un Score puede ser continuo, aunque los criterios estén organizados por niveles.
Otra característica especialmente útil es la posibilidad de plantear varias preguntas sobre el mismo contexto. Imaginemos que recibimos esta alerta:
El servicio de pagos está caído para todos los clientes. Los logs muestran agotamiento del pool de conexiones de base de datos y no existen indicios de acceso no autorizado.
Podríamos solicitar, en una única petición, la prioridad (Score de 0 a 4), el riesgo de seguridad (Noul) y el equipo responsable (Choice entre BACKEND, PLATFORM y SECURITY). El resultado sería algo parecido a esto (ejemplo conceptual, no una respuesta real de la API):
{
  "priority": 4,
  "security_risk": 0.03,
  "team": "BACKEND"
}
Es decir, no necesitamos tres llamadas ni un texto explicativo para disponer de las tres decisiones. El código que consume el resultado puede determinar qué hacer después.
TypeSafe pone el foco en otras tres características:
En su presentación oficial, TypeSafe comunicó latencias orientativas de 70 a 500 ms y una tarifa pública de 0,042 USD por millón de tokens de entrada, sin coste de tokens de salida. Son cifras publicadas por el proveedor, no una promesa de rendimiento en cualquier entorno ni una tarifa contractual garantizada. Conviene comprobar las condiciones vigentes antes de presupuestar.
Un último matiz: garantizar que una respuesta respete el esquema no significa garantizar que la decisión sea correcta. Un clasificador puede devolver perfectamente BILLING cuando la categoría que esperábamos era OTHER.
Un LLM generativo está diseñado para producir contenido. Jev está diseñado para emitir decisiones acotadas que otro software pueda utilizar directamente.
Esto no quiere decir que Claude, GPT o Gemini no puedan devolver resultados estructurados. Pueden hacerlo mediante herramientas, function calling o esquemas de salida. La diferencia es el objetivo nativo del modelo y su interfaz de interacción, no la imposibilidad de obtener JSON de un LLM.
Usando un LLM, el espacio de respuesta está potencialmente abierto, aunque como indico, se pueda intentar restringir. En Jev, el espacio de respuesta está ya definido por las propias preguntas. Además, un punto que tenemos que tener en cuenta es que Jev no te va a generar una explicación del razonamiento. Un LLM sí te puede decir qué le ha llevado a esa respuesta e incluso referencias a las citas asociadas.
La idea principal que tenemos que tener en mente es que Jev no tiene por qué competir frontalmente o sustituir a los LLM sino que en una arquitectura real pueden ser perfectamente complementarios.
Por ejemplo, un LLM puede diseñar una solución, redactar una respuesta o sintetizar un documento mientras que Jev puede decidir qué flujo ejecutar, qué categoría corresponde o si conviene derivar una operación a revisión humana.
Esto recuerda un principio de arquitectura bastante clásico: utilizar cada componente para aquello que hace mejor, evitando añadir capacidades que el problema no necesita. Ojo: siempre que podamos utilizar mecanismos deterministas siempre deberíamos optar por utilizarlos. Más sencillos de implementar, depurar, probar y desplegar.
Creo que donde de verdad tiene potencial es en los escenarios que cumplen condiciones como estas:
Dentro de estos condicionantes encontramos casos como:
Desde mi punto de vista de arquitecto, para mí no deja de ser un componente/servicio de decisión semántica que convive con reglas de negocio, APIs, eventos y modelos generativos, que es necesario en escenarios en los que un if/else convencional se queda corto, pero un LLM completo parece excesivo.
Eso sí, no sustituye a las reglas deterministas cuando podemos expresar y verificar completamente la decisión mediante código.
A veces, al analizar una tecnología nueva, nos centramos tanto en sus ventajas que dejamos de mirar el otro lado. En este caso creo que conviene ser especialmente cuidadosos. Por ejemplo:
Veamos estos escenarios con más detalle.
Tenemos que tener claro que Jev no es un modelo generativo. Por lo tanto, si necesitamos redactar un informe, desarrollar una arquitectura, explicar alternativas técnicas, programar, resumir un documento o mantener una conversación, Jev no es el modelo adecuado para producir ese artefacto.
Podría participar en decisiones del flujo, pero la generación seguiría correspondiendo a un LLM u otro sistema especializado.
Jev no proporciona una explicación de por qué ha elegido una categoría o ha asignado una puntuación. Podemos obtener señales asociadas a la decisión, pero no una descripción verificable de su razonamiento interno.
Pensemos en un correo que Jev clasifica como BILLING cuando un analista lo consideraría OTHER. Podemos saber qué devolvió y compararlo con la etiqueta esperada. Lo que no podemos pedirle es que nos detalle cuáles fueron sus razones internas para escoger esa opción.
La explicabilidad asociada a la IA es un requisito de mucha importancia en determinados contextos por lo que es un punto a tener muy en cuenta.
Podemos plantear una arquitectura híbrida:
Este modelo híbrido solo es aplicable si la explicación no es necesaria para continuar ya que podemos generarla de manera asíncrona y mantener fuera del camino crítico la latencia del segundo modelo. En este caso, no eliminamos la latencia de la explicación, la desacoplamos de la latencia de la decisión. Además, por otro lado, incorporamos un coste adicional, una dependencia y la necesidad de gestionar colas, reintentos y errores.
Ojo, existe una limitación todavía más importante: la justificación que redacte el LLM (ej: Haiku) sería una explicación posterior (post-hoc) no el razonamiento interno de Jev. Puede resultar útil para interpretar las evidencias y facilitar la revisión, pero también podría construir un argumento que no sea fiel al motivo real de la predicción.
Por eso, en procesos regulados o críticos que exijan una explicación validada antes de actuar, no podemos simplemente moverla a segundo plano y dar el requisito por resuelto.
Como he comentado anteriormente, en el momento en que estoy escribiendo el artículo, si necesitamos ejecutar el modelo sin conectividad externa, dentro de nuestra infraestructura o en una ubicación contractual concreta que TypeSafe no pueda ofrecer, Jev puede no cumplir los requisitos, independientemente de lo bien que clasifique.
Jev es un producto muy reciente: su presentación pública se produjo en septiembre de 2026. Obviamente, no estamos hablando de una tecnología con años de adopción generalizada, sino de una propuesta que está evolucionando rápidamente.
Eso no significa que no pueda utilizarse en producción. TypeSafe ya ha publicado el caso de Jack & Jill, una plataforma de empleo que, según su propio testimonio, sustituyó un modelo Gemini por Jev en una etapa de matching de candidatos. El caso reporta un 88 % menos de coste y una reducción del tiempo de procesamiento manteniendo una calidad comparable en esa tarea. Es un caso de cliente publicado por el proveedor: interesante como referencia, pero no equivale a una certificación independiente ni implica que esos ahorros sean extrapolables a otros sistemas.
TypeSafe continúa publicando versiones y funcionalidades. Por ejemplo, en el anuncio de Jev 1.14 diferencia las capacidades que considera suficientemente probadas de otras experimentales, como determinadas opciones multimodales o de contexto extendido.
Aquí hay un matiz que creo que merece un apartado propio, especialmente si estamos pensando en introducir Jev en una empresa grande y/o muy tradicional.
No podemos decir que TypeSafe no tenga soporte empresarial ya que dispone de una página específica para empresas con contacto comercial, capacidad para solicitar mayores límites de consumo y referencias a opciones como la retención cero de datos. Sin embargo, disponer de un canal comercial no equivale a tener confirmadas todas las garantías empresariales que exigiríamos antes de una adopción crítica:
Sí que es cierto que Typesafe se está moviendo en este ámbito. En el anuncio de su ronda de financiación del 9 de octubre de 2026, TypeSafe señala expresamente que añadirá más funcionalidades empresariales. Es una señal positiva de inversión y dirección de producto, pero también indica que la oferta continúa evolucionando y que saben que falta cierta madurez para un producto empresarial.
En mi opinión, en este momento, en un contexto empresarial, iría por utilizar Jev sin demasiadas reservas en una PoC controlada, pero condicionar el paso a producción crítica a una revisión comercial, legal, de seguridad y de operación. No basta con que el modelo sea rápido y acierte nuestro dataset.
Si falla el servicio un sábado por la noche, ¿a quién llamamos?, ¿qué tiempo de recuperación nos garantizan?, ¿qué hacemos si cambian las condiciones de la API?, ¿qué datos pueden tratar y en qué región? Esas respuestas deben estar por escrito, no inferirse de una página de marketing.
Mi lectura es que Jev merece ser evaluado para producción en casos acotados, pero exige especial atención a su madurez operativa y a las garantías contractuales. Antes de adoptarlo para una función crítica, revisaría al menos:
Conviene recordar que una decisión probabilística no debe convertirse automáticamente en una autorización. Si Jev indica que una acción parece segura, nuestro sistema sigue siendo responsable de comprobar permisos, políticas y restricciones.
En el momento en que estoy escribiendo este artículo, no he encontrado documentación oficial que confirme Jev como modelo seleccionable y administrado de forma nativa en Amazon, Google, Azure… Por tanto, no lo presentaría como una capacidad disponible en esas plataformas.
Si una organización quiere utilizarlo desde alguna de esas nubes, el escenario respaldado por la documentación pública es el consumo de la API de TypeSafe desde la aplicación. Cualquier acuerdo específico de despliegue privado o distribución mediante terceros debe confirmarse con el proveedor.
Tampoco he encontrado que se pueda ejecutar localmente. Esta limitación importa en organizaciones con requisitos estrictos de aislamiento, soberanía del dato o despliegue completamente on-premise.
En resumen: podemos desarrollar y desplegar nuestro software donde queramos, pero la inferencia de Jev, según la oferta pública documentada, depende del servicio de TypeSafe.
La clasificación de texto, el scoring y la detección de anomalías existían mucho antes de ChatGPT. Por tanto, dependiendo del contexto, es posible que no necesitemos ni Jev ni un LLM. Pensemos en el caso de clasificar correos. Una alternativa clásica sería entrenar un modelo supervisado a partir de mensajes etiquetados. Podemos empezar con TF-IDF y regresión logística, pasar a un SVM, combinar embeddings con un clasificador o ajustar un modelo encoder como ModernBERT. No todos requieren la misma cantidad de datos, hardware o esfuerzo de operación.
Otra posibilidad es utilizar soluciones gestionadas: Amazon Comprehend Custom Classification permite entrenar clasificadores con categorías propias y Google Cloud Document AI Custom Classifier ofrece opciones de clasificación documental, desde modelos preentrenados hasta entrenamiento personalizado. En abierto, enfoques como SetFit permiten ajustar clasificadores con relativamente pocos ejemplos y modelos de embeddings.
La comparación, por tanto, no debería limitarse a Jev frente a un LLM:
| Alternativa | ¿Qué necesitamos? | Principal atractivo | Principal contrapartida |
|---|---|---|---|
| Jev | Definir preguntas, criterios y validar los resultados sobre casos reales. | Prototipado rápido y decisiones tipadas sin entrenar un clasificador propio. | Dependencia del proveedor y restricciones de explicabilidad/despliegue. |
| Reglas deterministas | Criterios que podamos expresar con exactitud. | Previsibilidad, auditoría y coste mínimo. | Manejan mal la ambigüedad del lenguaje. |
| ML clásico o encoder especializado | Datos representativos, normalmente etiquetados, y un proceso de entrenamiento y mantenimiento. | Inferencia eficiente, control del modelo y posibilidad de despliegue propio. | Coste inicial de datos, entrenamiento, evaluación y actualización. |
| LLM pequeño con salida estructurada | Prompt, esquema y evaluación. | Flexibilidad y ecosistema amplio sin entrenamiento inicial. | Coste y latencia por llamada, aunque dependen del modelo y del volumen. |
No hay un ganador universal. Si disponemos de millones de correos históricos bien etiquetados y las clases apenas cambian, un clasificador especializado desplegado en nuestra infraestructura podría ser una opción excelente. Si, por el contrario, estamos explorando un proceso nuevo, tenemos pocas etiquetas y necesitamos cambiar los criterios con frecuencia, Jev puede reducir muchísimo la fricción inicial.
Tampoco sería correcto afirmar que el ML tradicional es necesariamente más lento de desarrollar o más caro de operar en todos los escenarios. Hay herramientas AutoML, modelos preentrenados y enfoques few-shot que han reducido mucho esa barrera. Y hay modelos supervisados que permiten inspeccionar qué variables han influido en una predicción, aunque eso tampoco garantiza por sí solo una explicación causal.
Como decía antes, tenemos que recordar siempre el principio de arquitectura de utilizar cada componente para aquello que hace mejor. En esta época de gran cambio y de gran velocidad en el cambio, el trabajo de arquitectura a la hora de diseñar soluciones es más importante que nunca: ¿qué necesitamos realmente? ¿un clasificador tradicional entrenado con nuestros datos, un LLM con salida estructurada o una API de decisiones como Jev o Decisions API?
La respuesta dependerá de calidad, coste, latencia, explicabilidad, privacidad, madurez y posibilidades de despliegue.
La industria está avanzando hacia resultados cada vez más estructurados, modelos más pequeños y servicios especializados, aunque no todos siguen el mismo camino.
Otro proyecto que merece la pena conocer es Laya, impulsado por Convai Innovations. Su planteamiento es muy similar al de Jev: tomar decisiones semánticas sobre un contexto mediante preguntas acotadas, en lugar de generar texto libre. De hecho, utiliza las mismas primitivas: Choice, Score y Noul, y puede resolver varias preguntas en una sola evaluación.
La diferencia más interesante está en el modelo de distribución. Laya es un proyecto open source, con código y pesos disponibles públicamente y una licencia Apache 2.0 declarada en su repositorio. Esto permite descargar el modelo y ejecutarlo localmente, dentro de un contenedor Docker o en infraestructura propia, en lugar de depender necesariamente de un servicio de inferencia externo.
Desde el punto de vista empresarial, de control y soberanía, esto puede ser bastante relevante ya que podemos controlar dónde se procesan los datos, qué versión ejecutamos y cómo integramos el modelo. Imaginemos una aseguradora que necesita clasificar documentación o priorizar incidencias y no puede enviar determinados datos a una API de terceros. Laya abre la posibilidad de desplegar ese componente dentro de sus propios límites de red.
Pero esto no es “gratis” ya que open source no equivale a una solución lista para producción empresarial. Como cualquier otro despliegue, hay que tener en cuenta que hay que proporcionar y analizar los costes asociados a la infraestructura, energía, personal…, hay que gestionar la capacidad, escalado, monitorización…, hay que mantener el modelo y las nuevas versiones que se generen del mismo, la responsabilidad operativa y el soporte cae del lado de la propia empresa y, al ser un proyecto Open Source, no tenemos soporte empresarial y tampoco tenemos la garantía de que vaya a ser mantenido en el tiempo (ojo, puede ser interesante que participemos como contribuidores).
Tampoco debemos olvidar la calidad de las decisiones. Necesitaríamos contrastar sus resultados con nuestro propio dataset, incluyendo textos ambiguos, distintos idiomas, distribuciones de categorías y casos donde conviene escalar a revisión humana. La precisión, la calibración y el comportamiento ante errores importan más que el hecho de ser abierto o propietario.
En mi opinión, Laya tiene mucho sentido como candidato para PoCs y para escenarios donde la ejecución local sea un requisito, pero para producción crítica exigiría el mismo rigor que a Jev: pruebas representativas, garantías de continuidad, controles de seguridad y un modelo de soporte claro.
Según el registro oficial de cambios de OpenAI, el 6 de octubre de 2026 se lanzó en beta la Decisions API con el modelo gpt-6-luna. Decisions API es una interfaz específica para evaluar entradas y devolver decisiones tipadas, con preguntas acotadas. Su planteamiento se parece bastante más al de System One de TypeSafe.
La correspondencia entre conceptos resulta llamativa y la forma de invocación es similar a la de System One: hay que indicar el modelo, las entradas y las preguntas/instrucciones. Las dos propuestas permiten trabajar con decisiones acotadas y múltiples preguntas sobre un contexto. La documentación de OpenAI describe además decisiones sobre texto e imágenes y señales de probabilidad o confianza en determinados tipos de respuesta.
OpenAI afirma que esta API puede ser aproximadamente diez veces más rápida que utilizar su Responses API para este tipo de tareas. Hay que interpretar bien esa cifra: es una comparación publicada por OpenAI frente a otra API propia, no una medición independiente contra Jev. Tampoco podemos concluir de ella que Luna sea más preciso, más rápido o más barato que Jev en nuestro escenario concreto.
Como es habitual en mis publicaciones, intento no dejar un post en algo meramente teórico y siempre procuro acompañarlo de algo “práctico”.
En este caso, he preparado este repositorio Jev Decision Lab. Consiste en una PoC que compara a Jev con Claude Haiku y Claude Sonnet sobre un conjunto de situaciones donde podemos medir resultados. Además, he incluído Laya para que lo puedas ejecutar en local.
No pretende ser un benchmark universal ni demostrar que Jev gana siempre. Su objetivo es poder jugar con ello y ver cuándo una decisión acotada puede resolverse sin recurrir a un modelo generativo generalista, y qué sucede con la calidad, el coste y el tiempo de respuesta.
Para que la PoC sea más guiada y sencilla de usar, he incluído una serie de casos de uso en los que la comparación tiene sentido:
| Caso de uso | Qué probamos | Tipo de decisión |
|---|---|---|
| Intelligent Model Routing | Elegir qué modelo utilizar para una tarea de software. | Choice |
| Intelligent Lead Scoring | Evaluar la madurez de una oportunidad comercial. | Score |
| Semantic Guardrails | Detectar peticiones que intentan omitir una aprobación. | Noul |
| Email Classification | Clasificar correos de negocio, incluido el spam. | Choice |
| Incident Prioritization | Asignar prioridad a incidencias operativas. | Score |
| Incident Triage | Obtener prioridad, riesgo de seguridad y equipo responsable a la vez. | Score + Noul + Choice |
| Architecture Decision & Planning | Diseñar y justificar una arquitectura.Este último caso es deliberado ya que también quiero mostrar dónde Jev no es la herramienta adecuada. | Solo generativos |
Por otro lado, en la PoC hay dos modos de uso:
En el repositorio está el README con las instrucciones completas, la descripción de los casos y los detalles de implementación.
Importante: las etiquetas del dataset son ejemplos preparados para la PoC, no un conjunto revisado de forma independiente. Un 95 % de coincidencia con estas etiquetas no equivale a "95 % de precisión en producción". Los costes son estimaciones, y el rendimiento depende también de la red y de los servicios externos.
Después de revisar la propuesta de TypeSafe y desarrollar la PoC, me quedo con varias ideas.
Por tanto, en lugar de que la primera pregunta que nos hacemos al diseñar una solución sea: “¿qué LLM utilizamos para resolver este problema?”, deberíamos empezar preguntando “¿qué tipo de inteligencia necesita realmente este problema?”. Si necesitamos generar, explicar o diseñar, un LLM tiene mucho sentido. Si necesitamos clasificar, priorizar o decidir dentro de límites definidos, propuestas como Jev abren una alternativa que merece ser explorada. Si el conjunto es predecible y está muy bien definido, vayamos a soluciones deterministas.
José Alberto Ruiz Casarrubios
Ingeniero informático de vocación, todoterreno de la tecnología y aprendiz incansable. Estoy siempre buscando nuevos retos a los que intentar aportar la mejor solución. Inmerso de lleno en el mundo del desarrollo de software y modernización de sistemas. Creyente de que aplicar el sentido común es la mejor de las metodologías y decisiones.
Ver más contenido de José Alberto.Leer más.


Los comentarios serán moderados. Serán visibles si aportan un argumento constructivo. Si no estás de acuerdo con algún punto, por favor, muestra tus opiniones de manera educada.

Cuéntanos qué te parece.